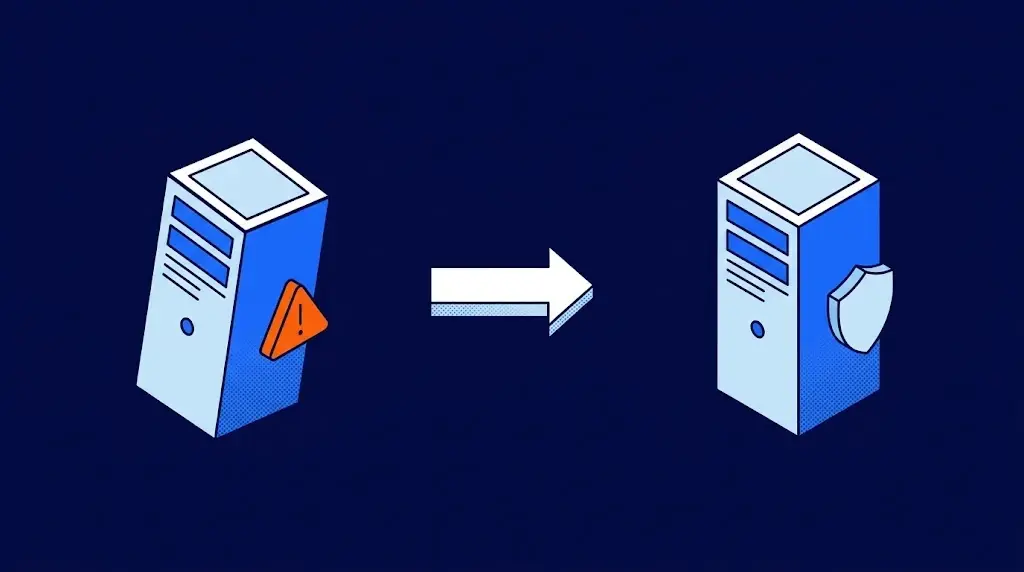
Un DRP (Disaster Recovery Plan o plan de recuperación ante desastres) es el documento y el conjunto de recursos técnicos que definen cómo una empresa recupera sus sistemas, su información y su operación después de una falla grave: un servidor que deja de funcionar, un ataque de ransomware, un error humano, un incendio o un corte prolongado de energía. Establece qué se recupera primero, en cuánto tiempo, a partir de qué copia, quién lo ejecuta y cómo se comprueba que funciona.
Esta guía responde lo que un director o responsable de TI necesita para preparar un DRP: qué debe incluir, cómo se fijan los tiempos de recuperación (RTO y RPO), en qué se diferencia de un backup y de un plan de continuidad (BCP), cómo se prueba y cuándo conviene contratarlo como servicio (DRaaS).
¿Qué es un DRP y para qué sirve?
DRP son las siglas de Disaster Recovery Plan. En español se le llama plan de recuperación ante desastres o plan de recuperación de desastres, y en muchas empresas simplemente "el plan de contingencia de TI". Todos los nombres apuntan a lo mismo: la respuesta escrita, probada y lista para ejecutarse cuando los sistemas que sostienen la operación dejan de funcionar.
La forma más fácil de entenderlo es pensar en el plan de protección civil de tu edificio. Hay rutas de evacuación señaladas, un punto de reunión, brigadistas con chaleco que saben qué hacer y un simulacro cada 19 de septiembre para comprobar que todo eso funciona. Un DRP es exactamente eso, pero para tus servidores, tus aplicaciones y tu información: sabes a dónde se mueve la operación, quién la mueve, en cuánto tiempo y cómo regresa a la normalidad.
Un ejemplo concreto. Un viernes a las 6 de la tarde, el servidor donde vive el sistema de facturación deja de responder y no vuelve a encender. Sin un plan, tu equipo de TI pasa el fin de semana improvisando: buscando la última copia, consiguiendo hardware, reinstalando y cruzando los dedos. Con un DRP, la misma persona abre el documento, sigue los pasos, levanta el sistema en el sitio alterno y el lunes a las 8 el área de ventas factura como cualquier otro día.
Un DRP también sirve para algo menos visible: demostrar. Normas como ISO 27001, los contratos con clientes corporativos y las pólizas de ciberseguro piden un plan de recuperación documentado y con pruebas. Tener el plan escrito y ensayado convierte una pregunta incómoda del auditor en un entregable que ya tienes listo.
Backup, DRP y BCP: en qué se diferencian
Los tres términos se mezclan seguido y conviene separarlos, porque cada uno responde a una pregunta distinta. El backup es la copia de tu información. El DRP es el plan para volver a operar tus sistemas a partir de esa copia. El BCP (Business Continuity Plan o plan de continuidad de negocio) es el plan de toda la empresa para seguir trabajando mientras eso pasa: qué hace ventas, qué hace almacén, qué se le dice a los clientes.
| Pregunta que responde | Backup | DRP | BCP |
|---|---|---|---|
| ¿Qué protege? | Archivos, bases de datos y buzones de correo. | Servidores, aplicaciones y la infraestructura que los sostiene. | Los procesos del negocio: vender, producir, cobrar, atender. |
| ¿Qué entrega? | Una copia de la información en un momento del tiempo. | Los sistemas funcionando otra vez, en un tiempo definido. | La empresa operando aunque los sistemas no estén al 100%. |
| ¿Quién lo ejecuta? | El equipo de TI o el proveedor de respaldo. | El equipo de TI, con el proveedor de recuperación si lo hay. | Dirección y los responsables de cada área. |
| ¿Es suficiente solo? | No. Sin plan, restaurar puede tomar días. | No sin backup: el plan necesita una copia desde donde recuperar. | No sin DRP: los procesos dependen de los sistemas. |
La relación es de capas. El respaldo es la base: sin una copia verificada no hay nada que recuperar, y por eso el punto de partida siempre es un servicio de backup administrado que compruebe que las copias restauran.
El BCP va por encima del DRP y lo incluye como su capítulo tecnológico. Profundizamos en esa relación en nuestro artículo sobre la diferencia entre BCP y DRP.
RTO y RPO: los dos números que definen tu plan
Todo DRP se construye sobre dos cifras que dirección debe fijar junto con TI. El RTO (Recovery Time Objective, objetivo de tiempo de recuperación) es cuánto tiempo puede estar detenido un sistema antes de que el negocio empiece a perder de verdad. El RPO (Recovery Point Objective, objetivo de punto de recuperación) es cuánta información aceptas perder, medida en tiempo desde la última copia.
Vuelve al simulacro. El RTO es cuánto tardan todas las personas en llegar al punto de reunión. El RPO es lo que dejaron sobre el escritorio al salir. Un edificio con un buen plan mide los dos y trabaja para acortarlos.
En la práctica se fijan por sistema, no para toda la empresa. El sistema de facturación de una distribuidora puede necesitar un RTO de una hora y un RPO de 15 minutos, porque cada pedido que no se captura es una venta que se pierde. El archivo histórico de contratos puede vivir con un RTO de dos días y un RPO de 24 horas sin que nadie lo note. Ponerle el mismo número a todo encarece el plan sin hacerlo mejor.
Estos dos números deciden la tecnología que necesitas: un RPO de minutos exige réplica continua a otro sitio, un RPO de un día se cubre con un respaldo nocturno. Explicamos cómo calcularlos con ejemplos en nuestra guía de RTO y RPO.
Qué debe incluir un disaster recovery plan
Un DRP completo cabe en un documento de pocas páginas, siempre que tenga estas siete partes. Si el tuyo ya existe, úsalas como lista de verificación.
- Inventario de sistemas con prioridad. Qué servidores, aplicaciones y bases de datos existen, de qué dependen entre sí y en qué orden se recuperan. El ERP y la facturación suelen ir primero; el servidor de archivos compartidos, después.
- Análisis de impacto. Qué cuesta cada hora sin cada sistema, en pedidos, en producción o en personas detenidas. Es el argumento que justifica el presupuesto del plan.
- RTO y RPO por sistema. Los dos números de la sección anterior, escritos y firmados por dirección.
- Estrategia de recuperación. Desde dónde se recupera cada sistema: respaldo restaurado en hardware nuevo, réplica en un segundo sitio o ambiente encendido en la nube.
- Roles y cadena de contacto. Quién declara el desastre, quién ejecuta cada paso, quién avisa a dirección y a los clientes, y a qué teléfono se llama al proveedor. Son tus brigadistas, con nombre y suplente.
- Procedimiento paso a paso. El runbook: la secuencia exacta de acciones para levantar cada sistema, escrita para que la pueda seguir alguien que no lo hace todos los días.
- Calendario de pruebas y revisión. Cuándo se ensaya, cómo se documenta el resultado y cuándo se actualiza el plan. Un DRP que no se prueba es una hipótesis.
Cómo preparar tu DRP en seis pasos
Preparar un plan de recuperación de desastres no requiere un proyecto de meses. Requiere orden. Estos seis pasos llevan a una empresa mediana de cero a un plan probado.
1. Haz la lista y ordénala
Reúne a TI con los responsables de cada área y pregunta una sola cosa: si este sistema se apaga ahora, ¿qué deja de pasar en tu área? Con las respuestas ordenas el inventario por impacto real, no por lo que TI supone. Una sorpresa frecuente es descubrir que una hoja de cálculo compartida es tan crítica como el ERP.
2. Ponle números a cada sistema
Fija el RTO y el RPO de cada sistema con quien lo usa. Ventas dirá que facturación no puede parar más de una hora; recursos humanos aceptará que la nómina espere un día si no es quincena. Esos números son el contrato entre el negocio y TI.
3. Decide dónde vive la copia y el sitio alterno
La regla básica es que la recuperación no puede depender del mismo lugar que falló. Si el servidor y su respaldo están en el mismo cuarto, un incendio o un robo se lleva los dos. Por eso cada vez más empresas replican a la nube: el segundo sitio ya existe, está lejos y no hay que construirlo. Reunimos los argumentos en las principales ventajas de la recuperación ante desastres en la nube.
4. Escribe el protocolo
Documenta quién declara el evento, quién enciende qué y en qué orden, cómo se avisa a dirección y qué se le dice a los clientes. Escríbelo para la peor hora posible: la persona que lo ejecute puede ser el suplente, a las 3 de la mañana, con el responsable de vacaciones. Si el procedimiento solo lo entiende quien lo escribió, no está terminado.
5. Ensaya
Programa el primer simulacro antes de dar por terminado el plan. Casi siempre aparecen tres o cuatro detalles que en el papel se veían bien: una contraseña que nadie tenía, un servidor que dependía de otro que no estaba en la lista, un teléfono desactualizado. Corregirlos en un ensayo cuesta una tarde; descubrirlos en una falla real cuesta la recuperación.
6. Revisa cada vez que algo cambie
Un servidor nuevo, una aplicación que se movió a la nube, un colaborador clave que se fue: cada cambio en tu infraestructura o en tu equipo es una revisión del plan. Fija además una revisión completa al año, alineada con la prueba principal.
Pruebas del DRP: el simulacro que le da valor al plan
Las pruebas del DRP son lo que separa un plan que funciona de un documento en una carpeta. Igual que el simulacro de sismo, su valor no está en que salga perfecto, sino en medir tiempos y encontrar lo que falla mientras no cuesta nada. Hay tres niveles y una empresa madura usa los tres.
- Revisión de escritorio. El equipo recorre el documento paso a paso, sin tocar sistemas, y confirma que cada acción tiene responsable, acceso y orden correcto. Se hace en una o dos horas y conviene repetirla cada trimestre.
- Prueba parcial. Se recupera un sistema concreto en el sitio alterno, sin afectar producción, y se mide cuánto tardó frente al RTO comprometido. Es la prueba que más enseña.
- Prueba completa. Se enciende toda la operación crítica en el sitio alterno y las áreas trabajan ahí durante un tiempo definido. Se programa al menos una vez al año, con dirección enterada y el resultado documentado.
Un ejemplo de lo que produce una prueba parcial: el plan decía que facturación se levantaba en una hora; la prueba tomó dos horas y veinte minutos porque la base de datos dependía de un servicio de autenticación que nadie había incluido. Se agregó al inventario, se repitió el mes siguiente y tomó 50 minutos. Ese registro, con fecha y tiempos, es exactamente lo que pide un auditor de ISO 27001 o una aseguradora.
DRP tradicional vs DRP como servicio (DRaaS)
Hay dos formas de tener el sitio alterno. La tradicional es construirlo: un segundo cuarto de servidores, propio o rentado, con hardware equivalente al principal, listo por si acaso. La otra es contratarlo como servicio: DRaaS (Disaster Recovery as a Service). Un agente replica tus servidores a la nube de forma continua y, cuando hace falta, el proveedor enciende ahí un ambiente idéntico al tuyo.
| Punto a comparar | Sitio alterno propio | DRP como servicio (DRaaS) |
|---|---|---|
| Inversión inicial | Hardware, licencias, enlaces y espacio duplicados antes de la primera falla. | Ninguna. Una mensualidad por servidor protegido y por almacenamiento. |
| Tiempo para tenerlo listo | Meses, entre comprar, instalar y configurar. | Días. Se instala el agente y comienza la réplica. |
| Quién ejecuta la recuperación | Tu equipo de TI, con el procedimiento que haya escrito. | El proveedor junto con tu equipo, siguiendo un runbook acordado. |
| Pruebas | Dependen de que TI encuentre tiempo y ventana. | Incluidas en el contrato, con fecha y evidencia. |
| Costo cuando no pasa nada | El mismo todo el año: el hardware duplicado existe aunque no se use. | Bajo: las horas de cómputo en la nube se pagan solo al encender el ambiente. |
| Crecimiento | Cada servidor nuevo exige comprar su gemelo. | Se suma el servidor al plan. |
El sitio propio sigue teniendo sentido para organizaciones con decenas de servidores físicos, reglas estrictas sobre dónde puede vivir su información o un segundo centro de datos que ya existe. Para la mayoría de las empresas medianas, el servicio arranca antes, cuesta menos mientras no pasa nada y trae las pruebas incluidas.
TecnetProtect DR: tu segundo sitio en la nube, ya listo
En TecnetOne resolvemos la recuperación ante desastres con TecnetProtect DR, nuestro servicio de DRaaS. Un agente instalado en tu infraestructura replica cada cambio de tus servidores hacia la nube, casi en tiempo real, las 24 horas. Cuando ocurre una falla, la confirmamos junto con tu equipo de TI, encendemos en minutos un ambiente idéntico al tuyo en la nube y tu operación sigue trabajando ahí mientras resolvemos tu sitio original. Cuando está listo, regresamos la información al día y apagamos el ambiente alterno.
El servicio incluye dos pruebas de recuperación al año, de hasta cuatro horas cada una y sin afectar tu producción, que además son la evidencia que te pide tu auditor o tu aseguradora. Conserva los últimos siete días de tu réplica para volver a un punto anterior a un error o a un ataque, y las horas de nube se pagan solo cuando se enciende el ambiente, en un failover o en una prueba adicional. Operamos certificados en ISO 27001 y con soporte en español.
Preguntas frecuentes sobre el DRP
DRP significa Disaster Recovery Plan, plan de recuperación ante desastres. Es el plan documentado y probado que define cómo una empresa recupera sus sistemas y su información después de una falla grave, en qué orden y en cuánto tiempo.
El DRP recupera la tecnología: servidores, aplicaciones y datos. El BCP mantiene funcionando el negocio completo mientras eso ocurre: qué hace cada área, cómo se atiende a los clientes, quién decide. El DRP es el capítulo tecnológico del BCP. Lo desarrollamos en DRP y BCP: en qué se diferencian.
No. El backup es la copia de la información; el DRP es el plan para volver a operar a partir de ella, con tiempos, responsables y pasos definidos. Sin plan, restaurar desde un respaldo puede tomar días. Se complementan: el plan necesita la copia y la copia necesita el plan. Explicamos cómo trabajan juntos en backups y disaster recovery.
El RTO es el tiempo máximo que un sistema puede estar detenido. El RPO es la cantidad máxima de información que aceptas perder, medida en tiempo desde la última copia. Se fijan por sistema y determinan qué tecnología de recuperación necesitas. Tenemos una guía con ejemplos sobre qué son RTO y RPO.
Al menos una prueba completa al año y revisiones parciales cada trimestre, además de una revisión cada vez que cambie un sistema crítico. El resultado de cada prueba se documenta con fecha y tiempos: esa evidencia es la que piden ISO 27001, los clientes corporativos y las pólizas de ciberseguro.
DRaaS (Disaster Recovery as a Service) es la recuperación ante desastres contratada como servicio. Tus servidores se replican de forma continua a la nube del proveedor y, ante una falla, se enciende ahí un ambiente idéntico en minutos, sin construir un segundo sitio propio. Así opera nuestro servicio de disaster recovery para empresas.
Sí, cuando incluye recuperación a un punto anterior en el tiempo. Ante un cifrado, se enciende el ambiente en un momento previo al ataque y la operación continúa mientras se limpia el sitio original. Se complementa con respaldos inmutables, que son copias que nadie puede modificar ni borrar.
ISO 27001 pide preparar las tecnologías de la información para la continuidad del negocio y probar esa preparación. ISO 22301 es la norma específica de continuidad. En México, la LFPDPPP exige medidas de seguridad para los datos personales, y recuperar la información tras un incidente forma parte de ellas. Los contratos con corporativos y las pólizas de ciberseguro suelen pedir el plan y la evidencia de sus pruebas.

Zoilijee es Fundadora y KAM de TecnetOne, se especializa en desarrollo de negocios para entornos Cloud, Híbridos y Ciberresiliencia Empresarial, su visión principal es lograr capacitar y proteger a las organizaciones sobre las nuevas amenazas emergentes en TI. Con una sólida formación en Informática, ha impulsado el desarrollo de negocios tecnológicos de alto impacto para empresas de todos los sectores.


